- وبلاگ
- سازندگان ثروت: این صندوق های متقابل سهام بزرگ و میانی درپوش حداکثر بازده را در یک سال گذشته تحویل دادند
- شرکت های کانادایی پس از مراجعه به بورس سهام با بار مالیاتی غیر منتظره روبرو می شوند
- رونوشت ویدیویی
- تجزیه و تحلیل رایگان روزانه بیت کوین
- مکث ، نه یک محوری - چرا RBI نیاز به تصمیم MPC را احساس کرد
- APTOS چیست؟یک قاتل جدید اتریوم در حال افزایش است
- بازه های زمانی در تجارت چیست؟
- پیشنهادات عمومی اولیه (IPO) و راه اندازی اوراق بهادار
- اگر کارگزار وام مسکن هستید ، چگونه می توان در زمان کمتری در زمان کمتری قرار گرفت
آخرین مطالب
امکانات وب


رسانه های اجتماعی و پیش بینی بازار سهام: یک رویکرد بزرگ داده
Mazhar Javed Awan 1 ، 2 ، * ، Mohd Shafry Mohd Rahim 1 ، Haitham Nobanee 3 ، 4 ، 5 ، Ashna Munawar 2 ، Awais Yasin 6 and Azlan Mohd Zain 7
1 دانشکده محاسبات ، دانشکده مهندسی ، دانشگاه Teknologi مالزی ، Johor ، مالزی 2 گروه مهندسی نرم افزار ، دانشگاه مدیریت و فناوری ، لاهور ، پاکستان 3 کولاژ تجارت ، دانشگاه ابوظبی ، ابوظبی ، یونایتد عرب 4 مرکز آکسفورد برایمطالعات اسلامی ، دانشگاه آکسفورد ، آکسفورد ، انگلستان 5 دانشکده مدیریت دانشگاه لیورپول ، دانشگاه لیورپول ، لیورپول ، انگلستان 6 گروه مهندسی کامپیوتر ، دانشگاه ملی فناوری ، اسلام آباد ، دانشکده محاسبات 7 ، مرکز داده های بزرگ UTM، Universiti Teknologi Malaysia ، Johor ، Malaysia * نویسنده مربوطه: Mazhar Javed Awan. ایمیل: mazhar. awan@umt. edu. pk دریافت: 09 سپتامبر 2020 ؛پذیرفته شده: 21 دسامبر 2020
چکیده: داده های بزرگ مجموعه مجموعه داده های بزرگ از منابع سنتی و دیجیتال برای شناسایی روندها و الگوهای است. مقدار و تنوع داده های رایانه به دلایل زیادی به صورت تصاعدی در حال رشد است. به عنوان مثال ، خرده فروشان در حال ساختن بانکهای اطلاعاتی گسترده فعالیت فروش مشتری هستند. سازمان ها در حال کار بر روی خدمات مالی لجستیک هستند و رسانه های اجتماعی عمومی در حال به اشتراک گذاشتن مقدار زیادی از احساسات مربوط به قیمت فروش و محصولات هستند. چالش های داده های بزرگ شامل حجم و تنوع در هر دو داده ساختار یافته و بدون ساختار است. در این مقاله ، ما چندین مدل یادگیری ماشین را از طریق Spark Mllib با استفاده از Pyspark اجرا کردیم ، که مقیاس پذیر ، سریع ، به راحتی با سایر ابزارها ادغام می شود و عملکرد بهتری نسبت به مدل های سنتی دارد. ما سهام 10 شرکت برتر را که داده های آنها شامل قیمت سهام تاریخی است ، مطالعه کردیم که مدل های MLLIB مانند رگرسیون خطی ، رگرسیون خطی تعمیم یافته ، جنگل تصادفی و درخت تصمیم گیری. ما مدل های طبقه بندی رگرسیون ساده لوح و لجستیک را اجرا کردیم. نتایج تجربی نشان می دهد که رگرسیون خطی ، جنگل تصادفی و رگرسیون خطی عمومی ، دقت 80 ٪ -98 ٪ را ارائه می دهد. نتایج تجربی درخت تصمیم گیری به خوبی پیش بینی حرکات قیمت سهام در بورس سهام را به خوبی پیش بینی نکرد.
کلمات کلیدی: داده های بزرگ ؛تجزیه و تحلیل؛هوش مصنوعی ؛فراگیری ماشین؛بازار سهام ؛رسانه های اجتماعی ؛تحلیلی تجارت
کلان داده شامل اطلاعات عظیم ساختاریافته و بدون ساختار است که بر خلاف ساختارهای قبلی مانند پایگاه های داده رابطه ای [1] می تواند توسط مدل های ماشینی دستکاری شود. اهمیت روزافزون داده های بزرگ ناشی از استفاده رایج از فناوری جدید و دستگاه های هوشمند مانند گوشی های هوشمند و تبلت ها است. تجزیه و تحلیل داده های بزرگ به مدیریت حجم زیادی از داده های تولید شده توسط شرکت های مختلف کمک می کند و می تواند برای پیش بینی روندها استفاده شود [2].
Spark یک کتابخانه اولیه یادگیری ماشین با ابزارهایی مانند مقیاس پذیری، طراحی و زبان هایی مانند Scala، R و Python فراهم می کند. استفاده از یادگیری ماشین در یک محیط متوالی دارای نقاط ضعف بسیاری است، مانند زمان اجرای طولانی با مجموعه داده های بزرگ، وابستگی به کار، عدم مقیاس پذیری و حافظه محدود. Spark ابزارهایی را برای رسیدگی به این مشکلات فراهم می کند و مهندسی داده و علم را تسهیل می کند [3]. هر سرمایه گذار نیاز به پیش بینی قیمت سهام دارد که به آنها کمک می کند تا تصمیمات صحیحی برای خرید یا فروش بگیرند. پیش بینی بازار چالش اصلی سرمایه گذاران است. اطلاعاتی مانند اخبار و رسانه های اجتماعی را می توان برای پیش بینی بازار استفاده کرد [4].
عوامل خارجی مانند رسانه های اجتماعی [5] و وبلاگ ها می توانند برای تجزیه و تحلیل عملکرد یک شرکت استفاده شوند. تجزیه و تحلیل دقیق حجم عظیمی از داده ها دشوار است. پیش بینی بازار سهام نیازمند سیستمی است که می تواند با استفاده از الگوریتم های یادگیری ماشین ساخته شود. مدل های یادگیری ماشین و سایر تکنیک های داده کاوی مانند تجزیه و تحلیل سری های زمانی به پیش بینی قیمت سهام کمک می کند. فرآیند پیش بینی شامل بسیاری از عوامل و حجم عظیمی از داده ها است. از این رو، ما تکنیک های کلان داده را برای پیش بینی قیمت و روند سهام پیشنهاد می کنیم [6]. شکل 1 نشان می دهد که چگونه سرمایه گذاران به صورت دستی حرکت قیمت سهام را با استفاده از رسانه های اجتماعی پیش بینی می کنند.

شکل 1: تحلیل سرمایه گذار از طریق رسانه های اجتماعی در بازار سهام
بیشتر سرمایه گذاران اطلاعات بازار و شرکت را قبل از خرید سهام تجزیه و تحلیل می کنند. اطلاعات مربوط به بازار در رسانه های اجتماعی و اخبار، وبلاگ ها و نظرات مشتریان شرکت ها در دسترس است. بسیاری از سرمایه گذاران چنین اطلاعاتی را برای پیش بینی حرکت قیمت سهام تجزیه و تحلیل می کنند. تجزیه و تحلیل دستی این اطلاعات مستعد خطا است [7]. دقت در تجزیه و تحلیل داده ها ضروری است، اما عواملی مانند سرعت محاسبات نیز مهم هستند. عناصر خارجی مانند پخش مالی و رسانه های اجتماعی برای پیش بینی قیمت های بازار نیاز به یادگیری ماشینی دارند [8]. منابع اطلاعاتی داده های بدون ساختار را ارائه می دهند که مستقیماً در یادگیری ماشین استفاده نمی شود. از این رو، پیش پردازش مورد نیاز است [9].
ما مدل هایی را برای پیش بینی روند بازار ارائه می دهیم. الگوریتم های یادگیری ماشین رویکردهای مختلفی دارند. همه در چارچوب جرقه با استفاده از پایتون اعمال می شوند. از سیستم عامل های Databricks نیز استفاده می شود. ما در هر دو مجموعه داده های ساختاری و بدون ساختار بحث می کنیم.
مدل های دستگاه مانند رگرسیون خطی ، درخت تصمیم ، جنگل تصادفی و رگرسیون خطی تعمیم یافته برای ساختار مجموعه داده ها اعمال می شود. ورودی های اصلی بسته شدن قیمت ها و قیمت های تعدیل شده تنظیم شده است که برای پیش بینی رفتار قیمت سهام استفاده می شود. رگرسیون لجستیکی و مدلهای بیس بیو برای مجموعه داده های بدون ساختار مانند پیام و بررسی مشتریان و سرمایه گذاران اعمال می شود.
ما نتایج را برای پیش بینی مقادیر ذاتی قیمت سهم با استفاده از مدلهای فوق مقایسه می کنیم. ما از تکنیک های موجود و جدید مدل طبقه بندی یادگیری ماشین با سیستم عامل های مدرن Databricks و Pyspark با پایتون استفاده می کنیم. ما برای پیش بینی حرکات قیمت سهام از یک مجموعه داده تاریخ 10 ساله استفاده می کنیم. ما شامل اخبار روزانه و رسانه های اجتماعی (Yahoo! مالی ، توییتر) برای استفاده در تجزیه و تحلیل احساسات برای پیش بینی ارزش های ذاتی قیمت های سهم هستیم.
باقیمانده این مقاله به شرح زیر سازماندهی شده است. بخش 1 در مورد پیشینه و کار قبلی بحث می کند. بخش 2 در مورد مدل پیشنهادی بحث می کند و مجموعه داده ها (ساختار یافته و بدون ساختار) و کتابخانه های یادگیری ماشین جرقه را تعریف می کند. بخش 3 در مورد عملکرد و نتایج مدل ها بحث می کند و نتایج آنها را مقایسه می کند. بخش 4 در مورد نتیجه گیری و کار آینده ما بحث می کند.
پیش بینی یک چالش است زیرا سرمایه گذاران به دنبال پیش بینی دقیق ارزش بازار هستند و بسیاری از مدل ها پیشنهاد شده است. هر محقق سعی دارد بازار را به طور دقیق پیش بینی کند. پیش بینی بازار سهام مبتنی بر تکنیک های مختلف مربوط به داده های ساختاری و بدون ساختار است [10]. فلورین و همکاران.[11] استدلال كرد كه سرمایه گذاران دیدگاه مشتریان و داده های تاریخی را برای پیش بینی حرکات آینده قیمت سهام در نظر می گیرند.
خان [12] فرآیند جمع آوری پیام ها و بافت از داده های توییتر را برای پیش بینی حرکات قیمت سهم شرح داد و استدلال کرد که کلمات متوقف و نظرات بر نتایج تأثیر می گذارند زیرا داده های توییتر بدون ساختار هستند. قبل از استفاده از یک مدل جدید ، برای پیش بینی بهتر حرکات قیمت باید کلمات توقف را حذف کنند [13]. تجزیه و تحلیل احساسات برای پیش بینی حرکات قیمت سهام به داده های سهام اعمال شد [14]. تحقیقات ما به داده های توییتر بستگی دارد و یافته ها نشان می دهد که Bayes ساده لوح یک شاخص 50 ٪ دقیق برای پیش بینی حرکات قیمت سهام است که ناکافی است. این مقادیر از دست رفته بسیاری دارد زیرا بازار سهام در طول آخر هفته بسته است و این بر صحت نتایج تأثیر می گذارد [15].
هونگ خاطرنشان كرد: تجزیه و تحلیل علمی در مورد داده های تاریخی اعمال می شود كه در آن از روشهای ریاضی برای پیش بینی حرکات بازار سهام استفاده می شود [16]. Cakra و همکاران.[17] استفاده از اطلاعات تاریخی و تجزیه و تحلیل احساسات را برای پیش بینی حرکات قیمت سهم مورد مطالعه قرار داد ، اما نتیجه خوبی به دست نیاورد. محققان این سیستم را به دو بخش طبقه بندی کردند: اولین داده های جمع آوری شده از روزنامه ها و پروفایل های شرکت و دومین استفاده از الگوریتم های ساده لوح Bayes برای پردازش و نشانه گذاری داده ها [18]. پیش بینی آنها از حرکات قیمت سهام سهام 86 ٪ مقادیر صحیح را نشان داد.
پنگ [19] برای توصیف نمره احساسات پیام های مربوط به شرکت ها ، یک میلیون پیام از بازارهای مختلف و طبقه بندی متن کاربردی را تجزیه و تحلیل کرد. Preda و همکاران.[20] با پیش بینی ارزش مورد انتظار قیمت سهام و شاخص های بازار سهام ، مشکل عمده فروشی را تعریف کرد. مدل پیشنهادی به یک مدل فرعی متکی است که خطاهای مرتبط با داده های هرزنامه را از بین می برد.
میرا و همکاران.[21] در مورد طبقه بندی خطی با دستگاه بردار پشتیبانی (SVM) و شبکه های عصبی مصنوعی برای پیش بینی دقیق حرکات روزانه بازار بحث کرد. یک شبکه عصبی مصنوعی (ANN) و SVM معمولاً در رسیدگی به داده های ناهمگن و داده های مالی اعمال می شود. Rechthenthin ، Street و Srinivasan سیستمی را برای پیش بینی پچ پچ سهام بازار نفت ایالات متحده (USO) پیشنهاد کردند که می تواند شاخص USO را برای پیش بینی ارزش واقعی سهام بررسی کند. یاهوامور مالی اطلاعاتی در مورد تمام قیمت های افتتاح و بسته شدن USO دارد. رویکردهای یادگیری ماشین به روش های جرقه ، هادوپ و رگرسیون در ادبیات برای پیش بینی حرکات قیمت سهام استفاده شده است. Spark برای پیش بینی داده های زمان واقعی استفاده شد زیرا Hadoop با MapReduce نمی تواند به درستی در یک سیستم در زمان واقعی کار کند [22].
سیف و همکاران.[23] مدلی را برای پیش بینی بازارها با استفاده از اخبار و سایر عوامل خارجی پیشنهاد داد. الگوریتم های ماشین و سایر تکنیک های شبکه عصبی برای جمع آوری داده ها برای پیش بینی مقادیر دقیق استفاده شد. از تکنیک ساده لوح ، SVM و استخراج متن برای نهایی کردن مجموعه داده ها برای پیش بینی شاخص بازار سهام استفاده شد [23]. این سیستم دیدگاه های مثبت و منفی و اطلاعات قیمت باز و بسته سهام تاریخی را جمع آوری می کند تا پیش بینی ارزش بازار سهام را افزایش دهد. سیستم پیشنهادی داده های ناهمگن مانند اخبار ، رسانه های اجتماعی و حرکات تاریخی قیمت سهام را پیش بینی می کند. محققان اظهار داشتند كه نتایج الگوریتم K-Nearest همسایگان (KNN) مورد استفاده برای بررسی رابطه بین اخبار رسانه های اجتماعی و حرکت قیمت سهام قابل توجه است [24].
در این مقاله ، ما الگوریتم های هوش مصنوعی ، شبکه طبیعی و یادگیری ماشین را برای پیش بینی حرکات قیمت سهام شرح می دهیم. این مقاله یک روش را به دو بخش تقسیم می کند: پیش بینی و طبقه بندی. از تکنیک های پیش بینی مانند A ، CNN ، Bayes Naive ، NN و Signature Standard (DSS) برای پیش بینی یک مدل استفاده می شود. بخش دوم برخی از روشهای طبقه بندی مانند فیلتر ، بهینه سازی مبتنی بر فازی و روشهای KNN را که برای برخی از مجموعه داده ها برای ارزیابی ارزش بازار سهام اعمال می شود ، توصیف می کند. روش شبکه عصبی DSS در مدل ترکیبی برای پیش بینی حرکات قیمت سهام استفاده می شود. یانگ و همکاران.[25] مدلی را برای پیش بینی حرکات قیمت سهام با داده های بزرگ ، با داده های به دست آمده از رسانه های اجتماعی ارائه داد.
یانگ و همکاران. مدلی را برای پیش بینی ارزش بازار با داده های بزرگ پیشنهاد کرد. محققان داده های مربوط به پردازش در زمان واقعی را با استفاده از رسانه های اجتماعی جمع آوری کردند [25]. آنها قبل از استفاده از مدل ، کلمات توقف را حذف کردند و داده ها را برای پیش بینی شاخص بازار پردازش کردند. برای پیش بینی حرکات قیمت سهام ، آنها از مدل های دستگاهی مانند SVM ، درختان تصمیم گیری (DT) و جنگل تصادفی (RF) استفاده کردند تا ارزش بازار را پیش بینی کنند. ما از یک دستگاه بردار پشتیبانی یکپارچه (SVM) استفاده کرده ایم که آخرین مربع برای پیش بینی حرکات روزانه قیمت سهام برای پیش بینی ارزش روزانه شاخص بازار سهام و استفاده از بهینه سازی مقالات استفاده شده است.
در مطالعه ما ، ما به منابع مختلف داده-داده های ساختاری و بدون ساختار-برای پیش بینی حرکات آینده قیمت سهام متکی هستیم. ما چندین مدل استفاده کرده ایم که در مقایسه با مدل های اعمال شده در ادبیات نتایج بهتری کسب کرده اند.
3 مدل پیشنهادی
ما مدلی را برای کمک به سرمایه گذاران در تصمیم گیری در مورد خرید و فروش سهام پیشنهاد می کنیم. هدف این مدل پیش بینی حرکات قیمت سهام است.
این مدل در مورد داده های تاریخی ، توییتر و اخبار مربوط به شرکت های مختلف اعمال می شود. از اخبار تاریخی مجموعه داده های شرکت های مختلف برای پیش بینی ارزش های آینده سهام استفاده می شود.
ما از دو نوع مجموعه داده استفاده می کنیم. اول ، ما مجموعه داده های تاریخی شرکت ها را در 15 سال گذشته جمع می کنیم. مجموعه داده دوم از اخبار ، وبلاگ ها ، توییتر ، یاهو جمع آوری شده است. امور مالی ، و بررسی و پیام در مورد شرکت های مختلف ، به همراه منابعی مانند جستجوی Google Dataset و Kaggle. com.
3. 1. 1 مجموعه داده های تاریخی
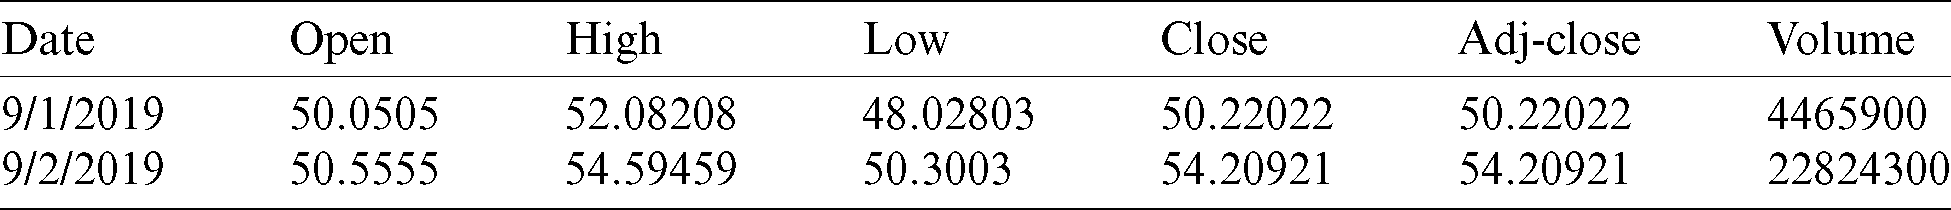
یاهومجموعه داده های مالی [26] می تواند شامل قیمت های نزدیک ، بالا ، باز و پایین شرکت ها باشد. قیمت های افتتاحیه قیمت هایی است که در هنگام باز شدن بورس سهام ، اولین سهام در آن تجارت می کند ، در حالی که بسته شدن قیمت ها قیمت سهام در پایان یک روز یا جلسه معاملاتی است که یک بازار سهام بسته می شود. ما همچنین می توانیم تاریخ یک شرکت را با استفاده از Yahoo! دریافت کنیم. رابط های برنامه نویسی برنامه (API) و مجموعه داده های Kaggle. com [27]. ما داده های تاریخی 10 شرکت را برای پیش بینی ارزش های آنها گرفتیم. نمونه هایی از شرکت ها و نمادهای آنها در برگه نشان داده شده است. 1
جدول 1: نام شرکت ها و نمادهای سهام

قیمت بسته بندی تعدیل شده (ADJ-CLOS) قیمت پایان روز معاملاتی یا جلسه تنظیم شده برای اقدامات شرکت ها مانند سود سهام یا تقسیم سهام است. محققان ممکن است از ارزش ADJ-CLOSE برای بررسی حرکات مورد انتظار قیمت سهم استفاده کنند. بسیاری از مقالات برای پیش بینی ارزش دقیق بازار از Adj-Close استفاده می کنند. برگه. 2 یک مجموعه داده تاریخی با ویژگی های داده های ساختاری نشان می دهد [27].
جدول 2: نمونه های مجموعه داده های ساختاری تاریخی
صفحه 3. 1. 2 اخبار/وبلاگ/پیام
داده های تجزیه و تحلیل احساسات را می توان از توییتر ، Yahoo! جمع آوری کردپیام های مالی ، kaggle. com و منابع دیگر. یاهوامور مالی دارای یک بستر معاملاتی است که اطلاعات شرکت ها را برای کمک به سرمایه گذاران در تجارت سهام شامل می شود.
سرمایه گذاران پروفایل شرکت ها ، داده های معاملاتی تاریخی ، اخبار ، نظرات تحلیلگران ، صورتهای مالی و پیام ها را مشاهده می کنند تا مشخص کنند که ارزش های اشتراک شرکت افزایش یافته یا کاهش یافته است. برای پیش بینی حرکات قیمت سهام ، از تکنیک های یادگیری ماشین برای این مجموعه داده ها استفاده می شود. تجزیه و تحلیل پیام ها به سرمایه گذاران کمک می کند تا تجارت خود را برنامه ریزی کنند. شکل 2 یاهو را نشان می دهد! پانل پیام مالی با تجزیه و تحلیل سرمایه گذار مختلف از داده های شرکت. شکل 2 ایده ای از چگونگی تجزیه و تحلیل سرمایه گذاران داده های بازار برای پیش بینی حرکات بازار را نشان می دهد.
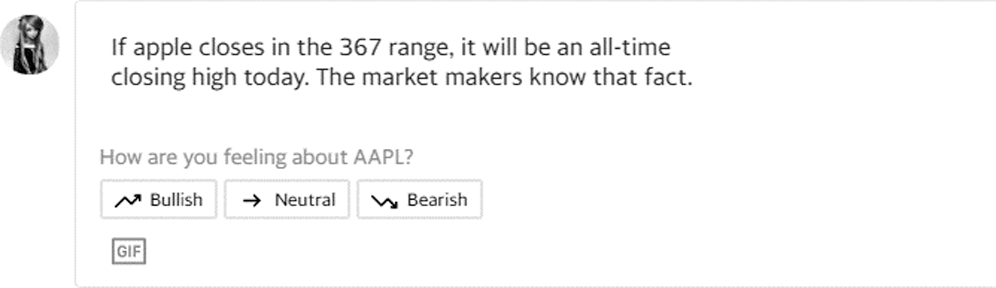
شکل 2: پیام سهام اپل (AAPL) در یاهو! امور مالی [20]
3. 2 پیش پردازش داده های تاریخی برای پیش بینی بازار سهام
ما داده ها را از Yahoo! Finance و Kaggle. comما می توانیم این مجموعه داده ها را به شکلی پردازش کنیم که استفاده از الگوریتم های یادگیری ماشین را برای تحلیل روندهای آینده بازار سهام تسهیل کند. یاهوداده های مالی در آخر هفته ها ارزش های گمشده ای خواهند داشت، زیرا بازار سهام بسته است، اما داده های توییتر چنین مقادیر گمشده ای ندارند [23]. ما می توانیم از برخی تکنیک های ریاضی برای کاهش و حذف قیمت های گمشده از مجموعه داده ها استفاده کنیم. برای مثال، فرض کنید می توانیم قیمت معاملات قبلی و فعلی را برای یک سهام در نظر بگیریم،

مقدار X راه حل بهتری برای پر کردن مقدار گمشده در حرکت بازار است. درصد قیمت بالا و پایین یک فرمول مهم برای پیش بینی بازار سهام است. معادله(1) برای جبران مقادیر از دست رفته استفاده می شود. معادله(2) به یافتن حرکت با درصد پایین و بالا در بازار کمک می کند:

هر دو فرمول از مدل ML-lib برای پیش بینی ارزش های آتی قیمت سهام استفاده می کنند. شکل 3 جریان کلی مدل ما را با استفاده از تکنیک های یادگیری ماشین نشان می دهد.
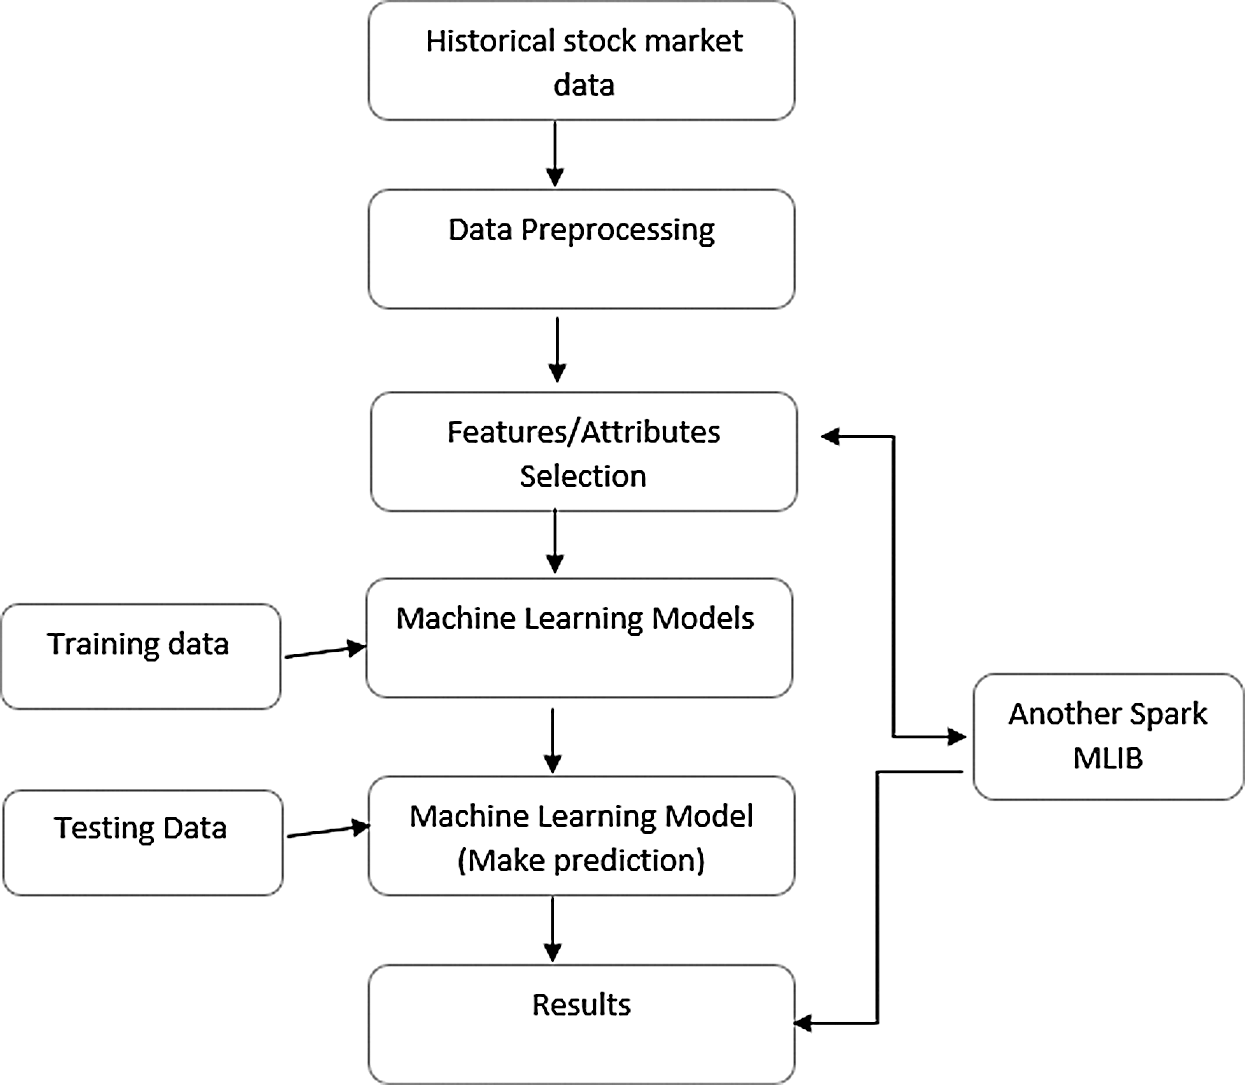
شکل 3: مدل پیش بینی بازار سهام
ما برخی از تکنیک های پردازش متن را برای مجموعه داده های بدون ساختار مانند رسانه های اجتماعی و اخبار اعمال می کنیم. ما نمی توانیم از مجموعه داده های بدون ساختار در مدل های ماشین استفاده کنیم. از این رو، تکنیک هایی مانند توکن سازی و پردازش متن برای حذف هرزنامه استفاده می شود. در Databricks از Spark با پایتون برای پردازش مجموعه داده ها استفاده کردیم. یک مجموعه داده را می توان با استفاده از یک زمینه Spark خواند. مجموعه داده ها به مجموعه داده های توزیع شده انعطاف پذیر (RDD) تبدیل می شوند، یک ساختار Spark که اجازه می دهد داده ها به خوشه ها تقسیم شوند.
3. 2. 2 مقادیر غیر عددی را به عددی تغییر دهید
ما ستون های ناخواسته را حذف می کنیم و مقادیر غیر عددی را به مجموعه داده های عددی تغییر می دهیم.
3. 2. 3 استخراج/انتخاب ویژگی
ما چندین تکنیک انتخاب ویژگی و استخراج ویژگی را به کار گرفته ایم تا از پیچیدگی های غیرضروری در مدل خود جلوگیری کنیم. ما می توانیم ویژگی هایی را انتخاب کنیم که دقت یک مدل را افزایش می دهد. ما RDD را به یک تابع بردار متراکم تبدیل می کنیم، پس از آن فریم های داده دارای برچسب ها و ویژگی های دو ستونی هستند. اینها را می توان به چارچوب های داده آموزشی و آزمایشی تقسیم کرد. ما MLlib را در Spark با پایتون اعمال می کنیم.
3. 3 تجزیه و تحلیل احساسات برای مجموعه داده های بدون ساختار
تجزیه و تحلیل احساسات را می توان برای مجموعه داده های بدون ساختار مانند پیام ها، اخبار و داده های استخراج شده از رسانه های اجتماعی اعمال کرد. تجزیه و تحلیل احساسات را می توان برای اخبار و پیام های بازار سهام اعمال کرد تا به سرمایه گذاران کمک کند تا حرکات قیمت سهام را شناسایی کنند.
از الگوریتم های ML می توان برای پیش بینی ارزش بعدی بازار سهام استفاده کرد. برای پیش بینی حرکت قیمت سهام از رگرسیون خطی، NB و DT استفاده می شود. این مدل ها در چارچوب Spark با استفاده از پایتون اعمال می شوند. پلتفرم های Databricks زمانی استفاده می شوند که این مدل ها در مجموعه داده ها برای یافتن مدل هایی که مقادیر دقیق شاخص سهام را ارائه می دهند، اعمال شوند.
داده ها با استفاده از مدل های پشتیبانی ML-LibMLlib مانند ساده بیز و ماشین بردار پشتیبان خطی تجزیه و تحلیل می شوند. قبل از استفاده از مدل، باید مجموعه داده ها را پردازش کنیم. شکل 4 مراحلی را نشان می دهد که قبل از استفاده از مدل های یادگیری ماشین باید دنبال شوند، به ویژه برای تجزیه و تحلیل احساسات.

شکل 4: مدل داده های رسانه های اجتماعی برای پیش بینی بازار
ما از Spark با پایتون برای پردازش مجموعه داده ها در Databricks استفاده می کنیم. یک مجموعه داده را می توان در زمینه Spark خواند. مجموعه داده ها به مجموعه داده های توزیع شده انعطاف پذیر (RDD) تبدیل می شوند، یک ساختار Spark که توسط آن داده ها را می توان به خوشه ها تقسیم کرد. سپس می توانیم RDD را به یک تابع برداری تبدیل کنیم. ما فریم های داده ای می سازیم که از برچسب ها و پیام های دو ستونی تشکیل شده است. ستون های پیام ممکن است اخبار یا متن رسانه های اجتماعی مرتبط با بازار سهام باشند.
Tokenization متن را به نشانه هایی تقسیم می کند که مدل های طبقه بندی برای آنها اعمال می شود. پس از حذف کلمات غیر ضروری، یک تابع را به مجموعه داده اعمال می کنیم.
3. 3. 3 حذف دو نقطه نماد و کلمات توقف
ما دو نقطه و کلمات توقف غیر ضروری را که می توانند بر نتایج مدل تأثیر بگذارند حذف می کنیم. این کار را می توان با استفاده از جعبه ابزار NLP انجام داد، جایی که هر کلمه را می توان از فرهنگ لغت مقایسه کرد و مطابقت های کلمات را حذف کرد.
3. 3. 4 هش کردن TF-IDF
در تحلیل از ابزار فرکانس مدت (TF) و فرکانس سند معکوس (IDF) استفاده شده است. این یک تابع ویژگی است که وزن کلمات را مشخص می کند و رابطه بین آنها را بیان می کند. پس از اعمال تمام توابع در چارچوب داده، می توانیم چارچوب اطلاعات را به آموزش و آزمایش تقسیم کنیم. ما کتابخانه یادگیری ماشین را با استفاده از Spark MLlib با پایتون اعمال می کنیم. در ادامه مدل دستگاه را شرح می دهیم.
3. 4 تکنیک های یادگیری ماشین
3. 4. 1 الگوریتم های رگرسیون خطی
LR برای یافتن وضعیت بین برچسب های مستقل و وابسته استفاده می شود که به پیش بینی مقادیر کمک می کند. LR روی بیش از یک برچسب مستقل کار می کند. ما از رگرسیون خطی چندگانه برای بررسی ارتباط بین برچسب های مستقل و وابسته استفاده کرده ایم. فرض کنید که a و b برچسب های مستقل یا وابسته هستند. معادله رگرسیون زیر است:

یک مفهوم مشابه می تواند در LR برای یافتن مقدار دقیق Spark استفاده شود. مدل LR به دستگاه تحت نظارت بستگی دارد. این ارزش قیمت سهام را پیش بینی می کند. مدل مقادیر مبتنی بر مقادیر قابل تغییر خود یا وابسته خود را هدف قرار می دهد. مدل LR قیمت هایی را که به مقادیر مستقل بستگی دارد ، پیش بینی می کند. این مدل را می توان در مجموعه داده های شرکت های مختلف برای پیش بینی مقادیر آینده قیمت سهام استفاده کرد. نتیجه اپل (AAPL) در شکل 5 ارائه شده است.
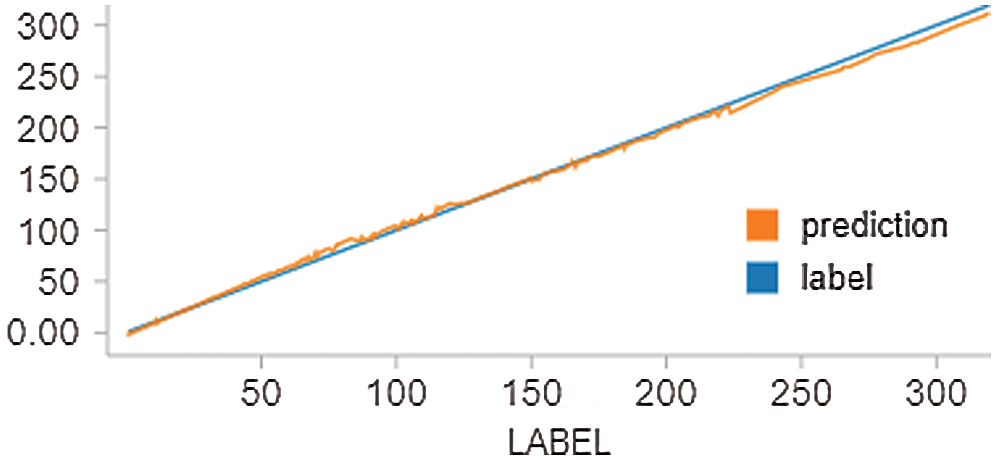
شکل 5: نتایج پیش بینی سهام AAPL
3. 4. 2 الگوریتم درخت تصمیم گیری
ما همچنین از مدل تصمیم گیری (DT) استفاده کرده ایم. این مدل به الگوریتم های یادگیری ماشین نظارت شده بستگی دارد. در این مدل ، ما داده ها را به چندین کلاس و ویژگی ها در هر مجموعه داده تقسیم کرده ایم. مدل درخت تصمیم گیری تحت نظارت است و در هر دو وظیفه رگرسیون و طبقه بندی کار می کند. این نمی تواند از جنگل تصادفی بهتر عمل کند. ما از این مدل با Spark استفاده می کنیم تا داده ها برای تجزیه و تحلیل آماده شود.
شکل 6 نتایج پیش بینی شده AAPL را با استفاده از این مدل نشان می دهد.
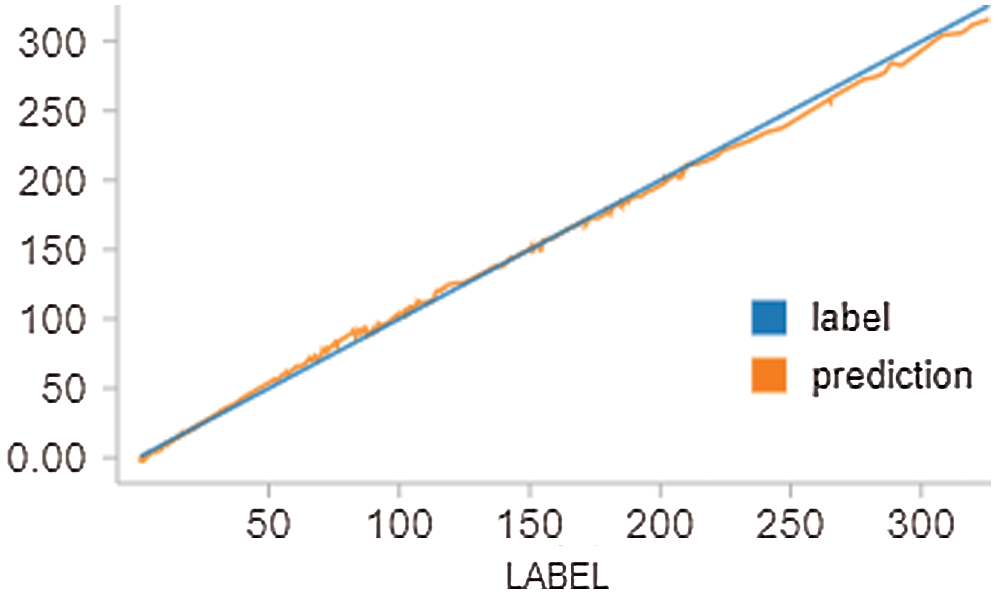
شکل 6: نتیجه سهام AAPL
3. 4. 3 رگرسیون خطی تعمیم یافته
رگرسیون خطی عمومی (GLR) نسبت به سایر مدل های LR سازگار است. بر خلاف رگرسیون خطی ، این مدل نیازی به داده ها برای پیروی از توزیع عادی ندارد ، مدل GLR با Spark تخمین دقیق تری را در مقایسه با یک مدل رگرسیون خطی ارائه می دهد.

Eq4 فرمول کلی مدل GLR را نشان می دهد. در این مقاله ، ما از این مدل با Spark برای پیش بینی حرکات قیمت سهام استفاده کردیم. ما این مدل را برای 10 شرکت مختلف اعمال کرده ایم. نتایج حاصل از این مدل دقیق تر از نتایج حاصل از مدل رگرسیون Leaner است. نتایج GLR در شکل 7 ارائه شده است.
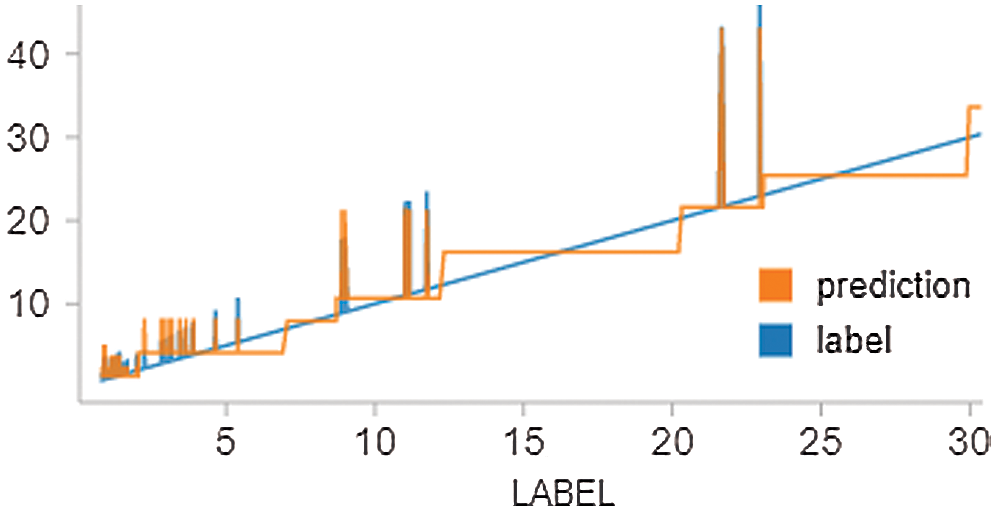
شکل 7: نتیجه سهام AAPL
3. 4. 4 جنگل تصادفی
مدل های جنگل تصادفی (RF) از الگوریتم های دستگاه نظارت شده تشکیل شده است. مدل RF شبیه به مدل درخت تصمیم (DM) است. با این وجود ، می تواند چندین درخت را با همان مجموعه داده ها اندازه گیری کرده و مقدار پیش بینی هر درخت را محاسبه کند. شکل 8 نتایج برآورد شده سهام اپل (AAPL) را با استفاده از مدل RF نشان می دهد. نتایج این مدل در پیش بینی حرکات قیمت سهام نسبت به نتایج حاصل از مدل DT دقیق تر است.
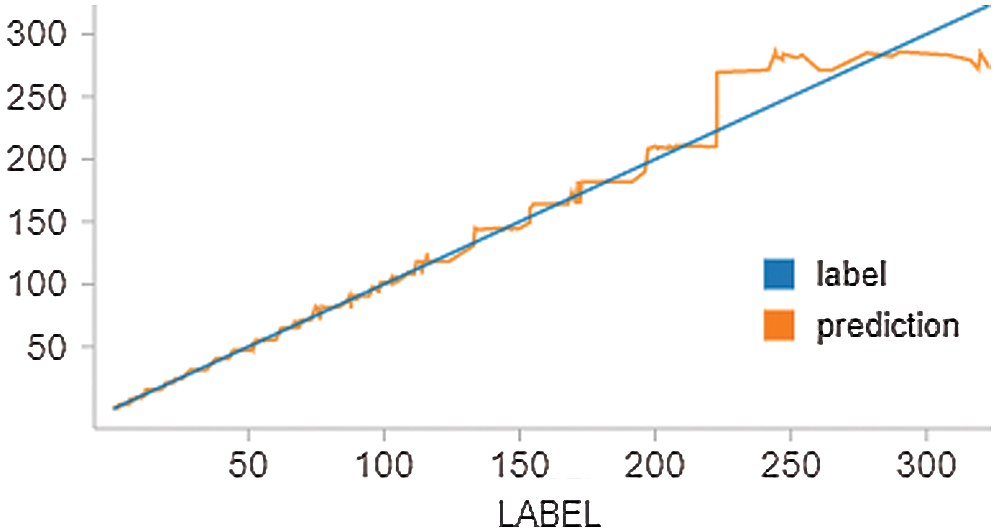
شکل 8: نتایج سهام AAPL
3. 4. 5 Bayes ساده لوح
تکواژ ساده بیز (NB) یک طبقه بندی است که از مدل ساده بیز استفاده می کند. ما از این مدل برای تجزیه و تحلیل داده های متنی جمع آوری شده از یاهو استفاده می کنیم! پایگاه داده مالی برای پیش بینی حرکات قیمت سهام بر اساس بررسی های سرمایه گذاران. نتایج مدل NB دقیق تر از نتایج مدل لجستیک-R است. شکل 9 نتایج اپل (AAPL) را نشان می دهد.
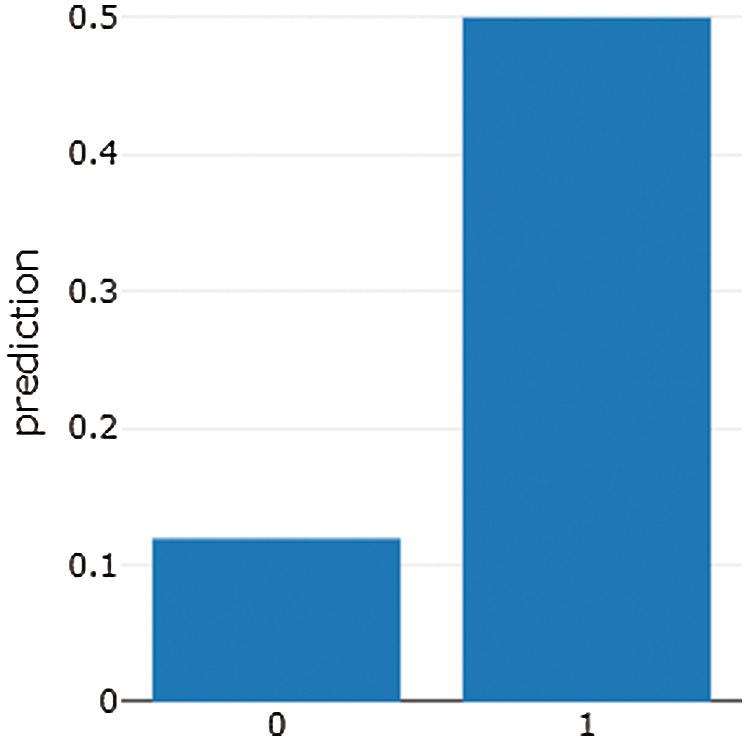
شکل 9: نتیجه پانل پیام سهام AAPL
3. 4. 6 رگرسیون لجستیک
رگرسیون لجستیک مدلی است که بر روی مجموعه ای مجزا از مقادیر و متن کار می کند. این یک مدل ساده است که با احتمال کار می کند و شبیه مدل NB است که برای طبقه بندی استفاده می شود. ما از این مدل برای پیش بینی قیمت های بازار سهام با استفاده از Spark MLB استفاده می کنیم. قبل از اعمال این مدل، طبقه بندی و نشانه گذاری متن را اعمال می کنیم. مدل لجستیک در پیش بینی حرکت قیمت سهام بهتر از سایر مدل ها عمل می کند. شکل 10 نتایج رگرسیون لجستیک را برای سهام اپل (AAPL) نشان می دهد.
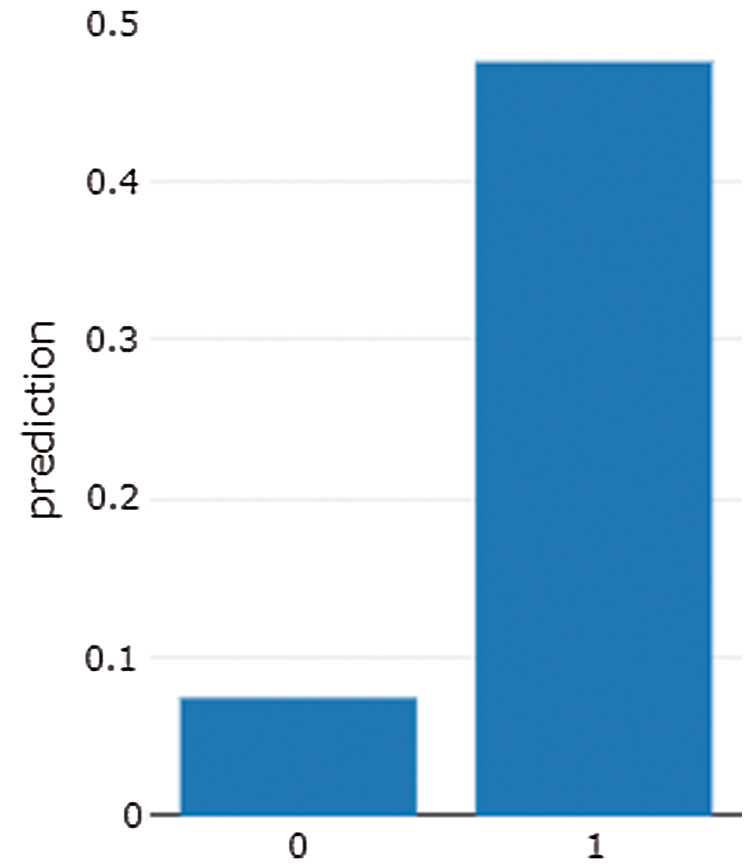
شکل 10: نمودار نتیجه پانل پیام سهام AAPL را نشان می دهد
4 ارزیابی عملکرد و نتیجه
در این بخش، نتایج همه مدل ها را با هم مقایسه می کنیم و مدلی را که دقیق ترین نتایج را در پیش بینی ارزش های آتی قیمت سهام ایجاد کرده است، برجسته می کنیم.
4. 1 نتایج مدل پیش بینی
ما چندین مدل را در پیش بینی ارزش های آتی قیمت سهام به کار گرفته ایم. شکل 11 نتایج تمام مدل ها (رگرسیون خطی، رگرسیون خطی تعمیم یافته، درخت تصمیم و جنگل تصادفی) را ارائه می دهد.
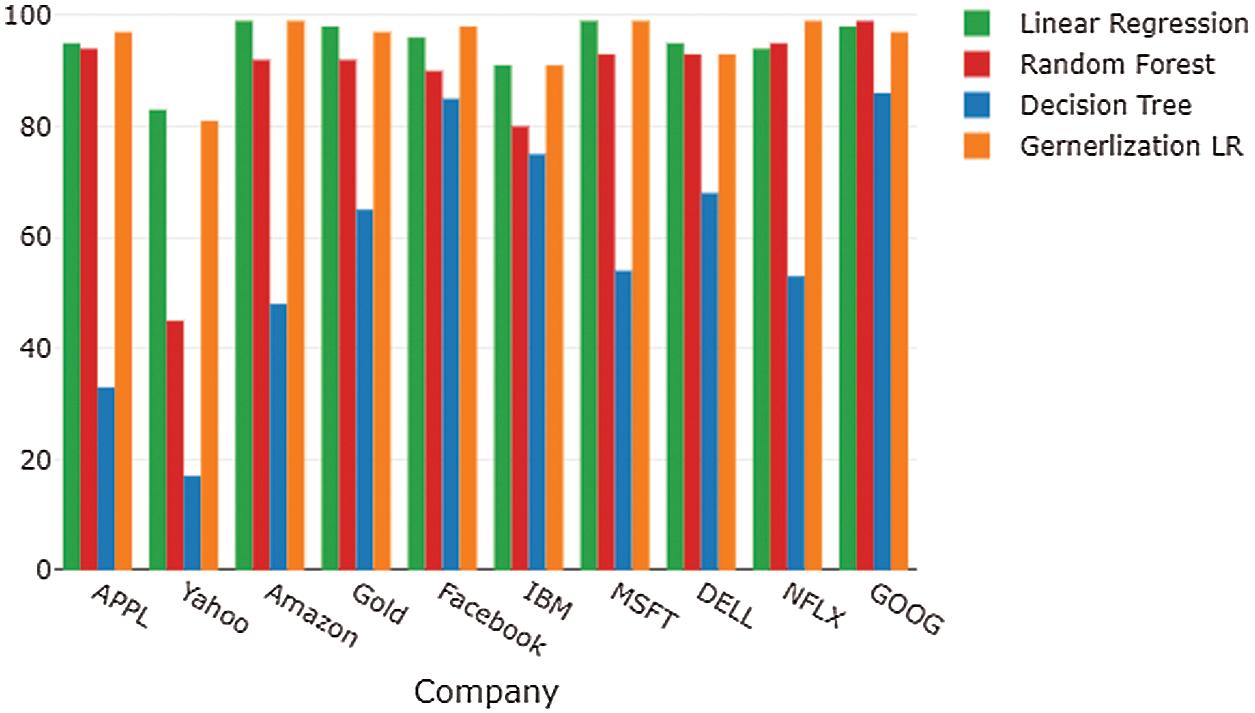
شکل 11: نتایج تاریخی 10 شرکت
نتیجه بالا نشان می دهد که کدام مدل ماشین در پیش بینی حرکت قیمت سهام دقیق تر است. دقت آنها را می توان با R2 و ریشه میانگین مربعات خطا (RMSE) اندازه گیری کرد که به شناسایی بهترین مدلی که حرکت قیمت سهام را پیش بینی می کند کمک می کند. Tab. 3 حرکات قیمت سهام اپل (APPL) را با استفاده از همه مدل ها نشان می دهد.
جدول 3: نتایج عوامل اندازه گیری بازار سهام APPL
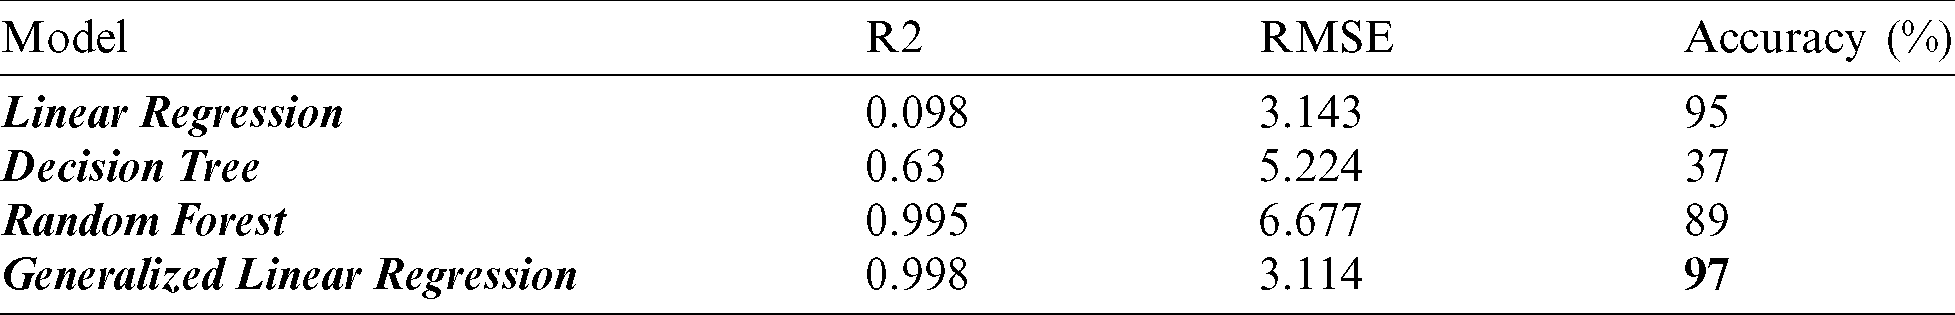
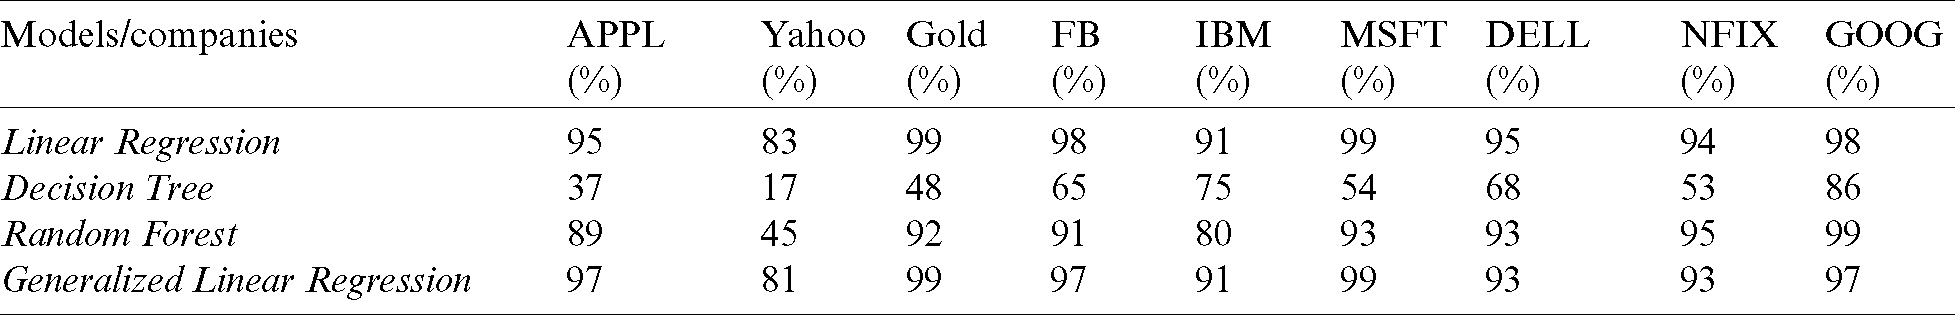
نتایج نشان می دهد که مدل های Spark MLlib با استفاده از داده های بزرگ نتایج دقیق تری نسبت به مدل های دیگر تولید می کنند و LR و GLR دقیق تر از مدل های دیگر هستند. ما این تکنیک ها را برای مجموعه داده های تاریخی بزرگتر اعمال می کنیم و دقت بهتری به دست می آوریم. Tab. 4 نتایج تمام مدل هایی را ارائه می دهد که نتایج دقیقی را تولید می کنند.
جدول 4: شرکت هایی که نتایج دقیق تولید می کنند
4. 2 نتایج مدل احساسات
ما نتایج بررسی پیام/مشتری را در قیمت سهام APPL تعریف می کنیم. این مجموعه داده ها به سرمایه گذاران کمک می کند تا افزایش و کاهش قیمت سهام را شناسایی کنند.
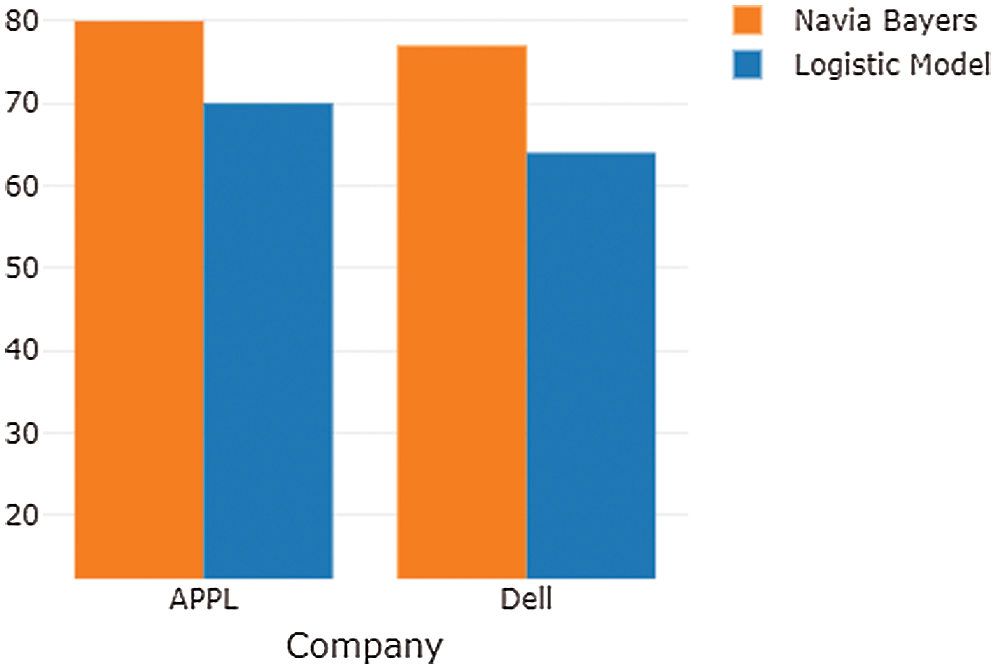
ما می توانیم مدل های طبقه بندی کننده ساده لوح و رگرسیون لجستیکی را در اخبار و پیام ها برای پیش بینی حرکت قیمت سهام اعمال کنیم. بیوها بیس تقریباً 60 ٪ -70 ٪ دقت می کنند ، بنابراین هر دو مدل دقت نزدیک را نشان می دهند. با این وجود ، مدل طبقه بندیگر تدارکات بهتر است ارزش حرکات قیمت سهام را پیش بینی کند ، زیرا 60 ٪ تا 80 ٪ دقت را ارائه می دهد.
شکل 12 نتایج مدل طبقه بندی متن (بیوها و رگرسیون لجستیک) را نشان می دهد ، هنگامی که به اخبار و پیام های مربوط به سهام Appl اعمال می شود. برگه. 5 نتایج را برای مدل های ساده لوح و مدل های لجستیک ارائه می دهد.
شکل 12: نتایج تجزیه و تحلیل احساسات APPL
جدول 5: مدل تجزیه و تحلیل احساسات برای شرکت های اپل و دل
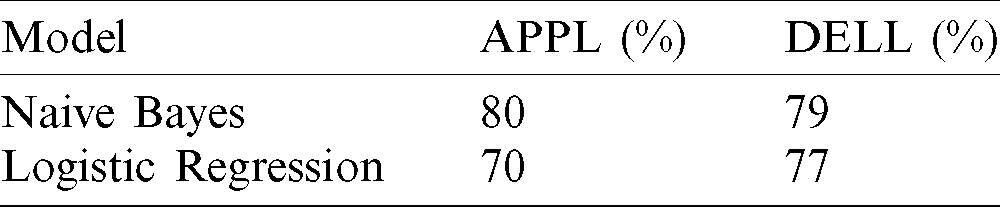
برگه. 4 نتایج مدل های NB و لجستیکی LR را هنگام استفاده از مجموعه داده های مختلف ارائه می دهد. داده ها از پانل پیام جمع آوری شده و با استفاده از تجزیه و تحلیل احساسات تجزیه و تحلیل می شوند. مدل NB با استفاده از پلتفرم Databricks ، دقت بهتری نسبت به مدل لجستیکی با Spark Mllib به دست می آورد. با استفاده از تکنیک های فوق ، سرمایه گذاران می توانند پیش بینی های دقیقی از حرکات قیمت سهام ایجاد کنند. مدل یادگیری ماشین بیشتر برای پیش بینی حرکات قیمت سهام استفاده می شود.
ما از چندین مدل یادگیری ماشین برای پیش بینی حرکات قیمت سهام از طریق چارچوب داده های بزرگ Spark استفاده کردیم. ما از Spark MLLIB برای پیش بینی حرکات قیمت سهام استفاده کردیم ، ما از کتابخانه های یادگیری ماشین در داده های تاریخی برای 10 شرکت استفاده کردیم. نتایج نشان می دهد که رگرسیون خطی ، جنگل تصادفی و رگرسیون خطی عمومی نتایج دقیق تری نسبت به مدل درخت تصمیم می گیرد. رگرسیون ساده لوح و رگرسیون تدارکات برای بافت نتایج داده ها تقریباً 77 ٪ تا 80 ٪ نسبت دقت را نشان می دهد. ما پیشنهاد می کنیم از مدل های یادگیری عمیق از طریق LSTM برای تحقیقات آینده استفاده کنید.
بیانیه بودجه: محققان کمک مالی خاصی از آژانس های تأمین مالی در بخش های عمومی ، تجاری یا غیر انتفاعی دریافت نکردند.
تضاد منافع: نویسندگان اعلام می کنند که هیچ تضاد منافع برای گزارش در مورد مطالعه حاضر ندارند.
منابع
- M. M. Hasan ، J. Popp and J. Oláh.(2020)."چشم انداز فعلی و تأثیر داده های بزرگ بر امور مالی" ، مجله Big Data ، جلد. 7 ، صص 1-17.
- X. لیو.(2020)."تجزیه و تحلیل تأثیر محتوای تولید شده توسط کاربر بر عملکرد سهام شرکت های B2B: تجزیه و تحلیل داده های بزرگ با روش های یادگیری ماشین ،" مدیریت بازاریابی صنعتی ، جلد. 86 ، صص 30-39.
- R. T. Whitman ، B. G. Marsh ، M. B. Park and G. E. Hoel.(2019). معاملات ACM در مورد الگوریتم ها و سیستم های مکانی ، جلد ، "توزیع شده در Apache Spark" توزیع شده در Apache Spark ". 5 ، نه. 1 ، صص 1-28.
- S. Coyne ، P. Madiraju and J. Coelho.(2017)."پیش بینی قیمت سهام با استفاده از تجزیه و تحلیل رسانه های اجتماعی" ، در سال 2017 IEEE 15th Int. کنفرانسدر مورد محاسبات قابل اعتماد ، خودمختار و ایمن ، پانزدهم Int. کنفرانسدر مورد هوش و محاسبات فراگیر ، 3 int. کنفرانسدر مورد اطلاعات بزرگ اطلاعات و محاسبات و علوم و فناوری سایبری کنگره (DASC/PICOM/DATACOM/CYBERSCITECHORLANDO ، صص 1031-1038.
- J. Peiran ، A. Veiga و A. Walther.(2020)."رسانه های اجتماعی ، رسانه های خبری و بازار سهام" ، مجله رفتار اقتصادی و سازمان ، جلد. 176 ، صص 63-90.
- M. C. Angadi و A. P. Kulkai.(2015)."تجزیه و تحلیل داده های سری زمانی برای پیش بینی بازار سهام با استفاده از تکنیک های داده کاوی با R" ، مجله بین المللی تحقیقات پیش نویس علوم کامپیوتر ، جلد. 6 ، نه. 6 ، صص 104-108.
- R. Batra و S. M. Daudpota.(2018)."ادغام سهام با تجزیه و تحلیل احساسات برای پیش بینی بهتر حرکت قیمت سهام" ، در سال 2018 Int. کنفرانسدر مورد محاسبات ، ریاضیات و فن آوری های مهندسی ، سوکور ، پاکستان ، صص 1-5.
- D. T. Selin و O. Tas.(2020)."احساسات رسانه های اجتماعی در بازده سهام بین المللی و فعالیت تجارت ،" مجله امور مالی رفتاری ، جلد. 1 ، صص 1-14.
- S. A. Bogle و W. D. Potter.(2015)."Sentamal- A تجزیه و تحلیل احساسات مدل پیش بینی سهام سهام ،" در Proc. در intکنفرانسدر مورد هوش مصنوعی ، صص 610.
- D. P. Gandhmal و K. Kumar.(2019)."تجزیه و تحلیل سیستماتیک و بررسی تکنیک های پیش بینی بازار سهام ،" بررسی علوم کامپیوتر ، جلد. 34 ، صص 100190.
- K. Florian ، F Manz و D. Schiereck.(2020). اقتصاد کاربردی ، جلد. 52 ، صص 1-13.
- دبلیو خان ، M. A. غزانفر ، M. A. Azam ، A. Karami و H. K. Alyoubi ، et al.(2020).، "پیش بینی بازار سهام با استفاده از طبقه بندی کننده های یادگیری ماشین و رسانه های اجتماعی ، اخبار ،" مجله هوش محیط و محاسبات انسانی ، جلد. 1 ، صص 1-24.
- S. Kalra و J. S. Prasad.(2019)."اثربخشی احساسات اخبار برای پیش بینی بازار سهام" ، در سال 2019 Int. کنفرانسدر مورد یادگیری ماشین ، داده های بزرگ ، ابر و محاسبات موازی ، فریدآباد ، هند ، صص 491-496.
- V. S. Pagolu ، K. N. Reddy ، G. Panda and B. Majhi.(2016)."تجزیه و تحلیل احساسات از داده های توییتر برای پیش بینی حرکات بازار سهام ،" در سال 2016 Int. کنفرانسدر پردازش سیگنال ، ارتباطات ، قدرت و سیستم تعبیه شده ، Paralakhemundi ، صص 1345-1350.
- J. Kordonis ، S. Symeonidis و A. Arampatzis.(2016)."پیش بینی قیمت سهام از طریق تجزیه و تحلیل احساسات در توییتر" ، در Proc. از بیست و یکم Conf. در مورد انفورماتیک ، پاتراس ، صص 1-6.
- S. Jeon ، B. Hong و V. Chang.(2018)."پیش بینی قیمت سهام مبتنی بر ردیابی الگوی با استفاده از داده های بزرگ" ، سیستم های رایانه ای آینده ، جلد. 80 ، صص 171-187.
- Y. E. Cakra و B. D. Trisedya.(2015)."پیش بینی قیمت سهام با استفاده از رگرسیون خطی بر اساس تجزیه و تحلیل احساسات ،" در سال 2015 Int. کنفرانسدر سیستم های پیشرفته علوم و اطلاعات رایانه ، DePok ، صص 147-154.
- D. K. Kirange و R. R. Deshmukh.(2016)."تجزیه و تحلیل احساسات از عناوین خبری برای پیش بینی قیمت سهام ،" Compusoft: مجله بین المللی فناوری پیشرفته رایانه ، جلد. 5 ، نه. 3 ، صص 2080-2084.
- Z. Peng.(2019)."تجزیه و تحلیل و پیش بینی سهام با استفاده از تجزیه و تحلیل داده های بزرگ" ، در سال 2019 Int. کنفرانسدر مورد حمل و نقل هوشمند ، Big Data & Smart City ، Changsha ، صص 309-312.
- S. Preda ، S. V. Oprea و A. Bâra.(2018)."پیش بینی PV با استفاده از یادگیری ماشین بردار پشتیبانی در یک زمینه تجزیه و تحلیل داده های بزرگ ،" تقارن (بازل) ، جلد. 10 ، نه. 12 ، صص 748.
- P. Misra و S. Chaurasia.(2020). مجله تحقیقات فناوری اطلاعات ، جلد. 13 ، نه. 1 ، صص 130-149.
- M. Rechenthin ، W. N. Street و P. Srinivasan.(2013)."پچ پچ پچ: استفاده از احساسات سهام برای پیش بینی جهت قیمت". 2 ، نه. 3-4 ، صص 169-196.
- M. M. Seif و E. M. R. Hamed.(2018)."مدل پیشنهادی زمان واقعی بازار سهام با استفاده از چارچوب Apache Spark" ، در Hassanien ، A. ، Tolba ، M. ، Elhoseny ، M. and Mostafa ، M. (Eds.) کنفرانس بین المللی فن آوری ها و برنامه های یادگیری ماشین پیشرفته (AMLTA2018AMLTA ،پیشرفت در سیستم های هوشمند و محاسبات ، جلد 723. چم: اسپرینگر.
- W. Wang ، K. Y. Ho ، W. M. R. Liu و K. T. Wang.(2013)."رابطه بین اخبار و پرش قیمت سهام: تجزیه و تحلیل مبتنی بر شبکه عصبی" ، در بیستمین کنگره بین المللی مدل سازی و شبیه سازی ، آدلاید ، استرالیا ، صص 2506-2512.
- R. Yang ، L. Yu ، Y. Zhao ، Y. Yu ، H. Xu et al.(2020).، "تجزیه و تحلیل داده های بزرگ برای پیش بینی نوسانات بازار مالی بر اساس دستگاه بردار پشتیبانی ،" مجله بین المللی مدیریت اطلاعات ، جلد. 50 ، صص 452-462.
- یاهو(2020)."بدون عنوان."پ. yahoo finance. com.[برخط]. موجود: http://finance. yahoo. com.
- D. جستجو.(2020)."بدون عنوان."[برخط]. موجود: https://datasetsearch. research. google. com/.
 | این کار تحت مجوز بین المللی Creative Commons Attribution 4. 0 بین المللی مجاز است ، که اجازه می دهد استفاده ، توزیع و تولید مثل بدون محدودیت در هر رسانه ای باشد ، مشروط بر اینکه کار اصلی به درستی ذکر شود. |

ما را در سایت فارکس وکسب درامد دنبال می کنید
برچسب :
نویسنده : مهدی اسدی
بازدید : <-PostHit->
آرشیو مطالب
خبرنامه
